
900MB로 완전 오프라인 구동하는 소형 언어모델 — 리퀴드 AI의 LFM2.5-1.2B-싱킹 해설

도입
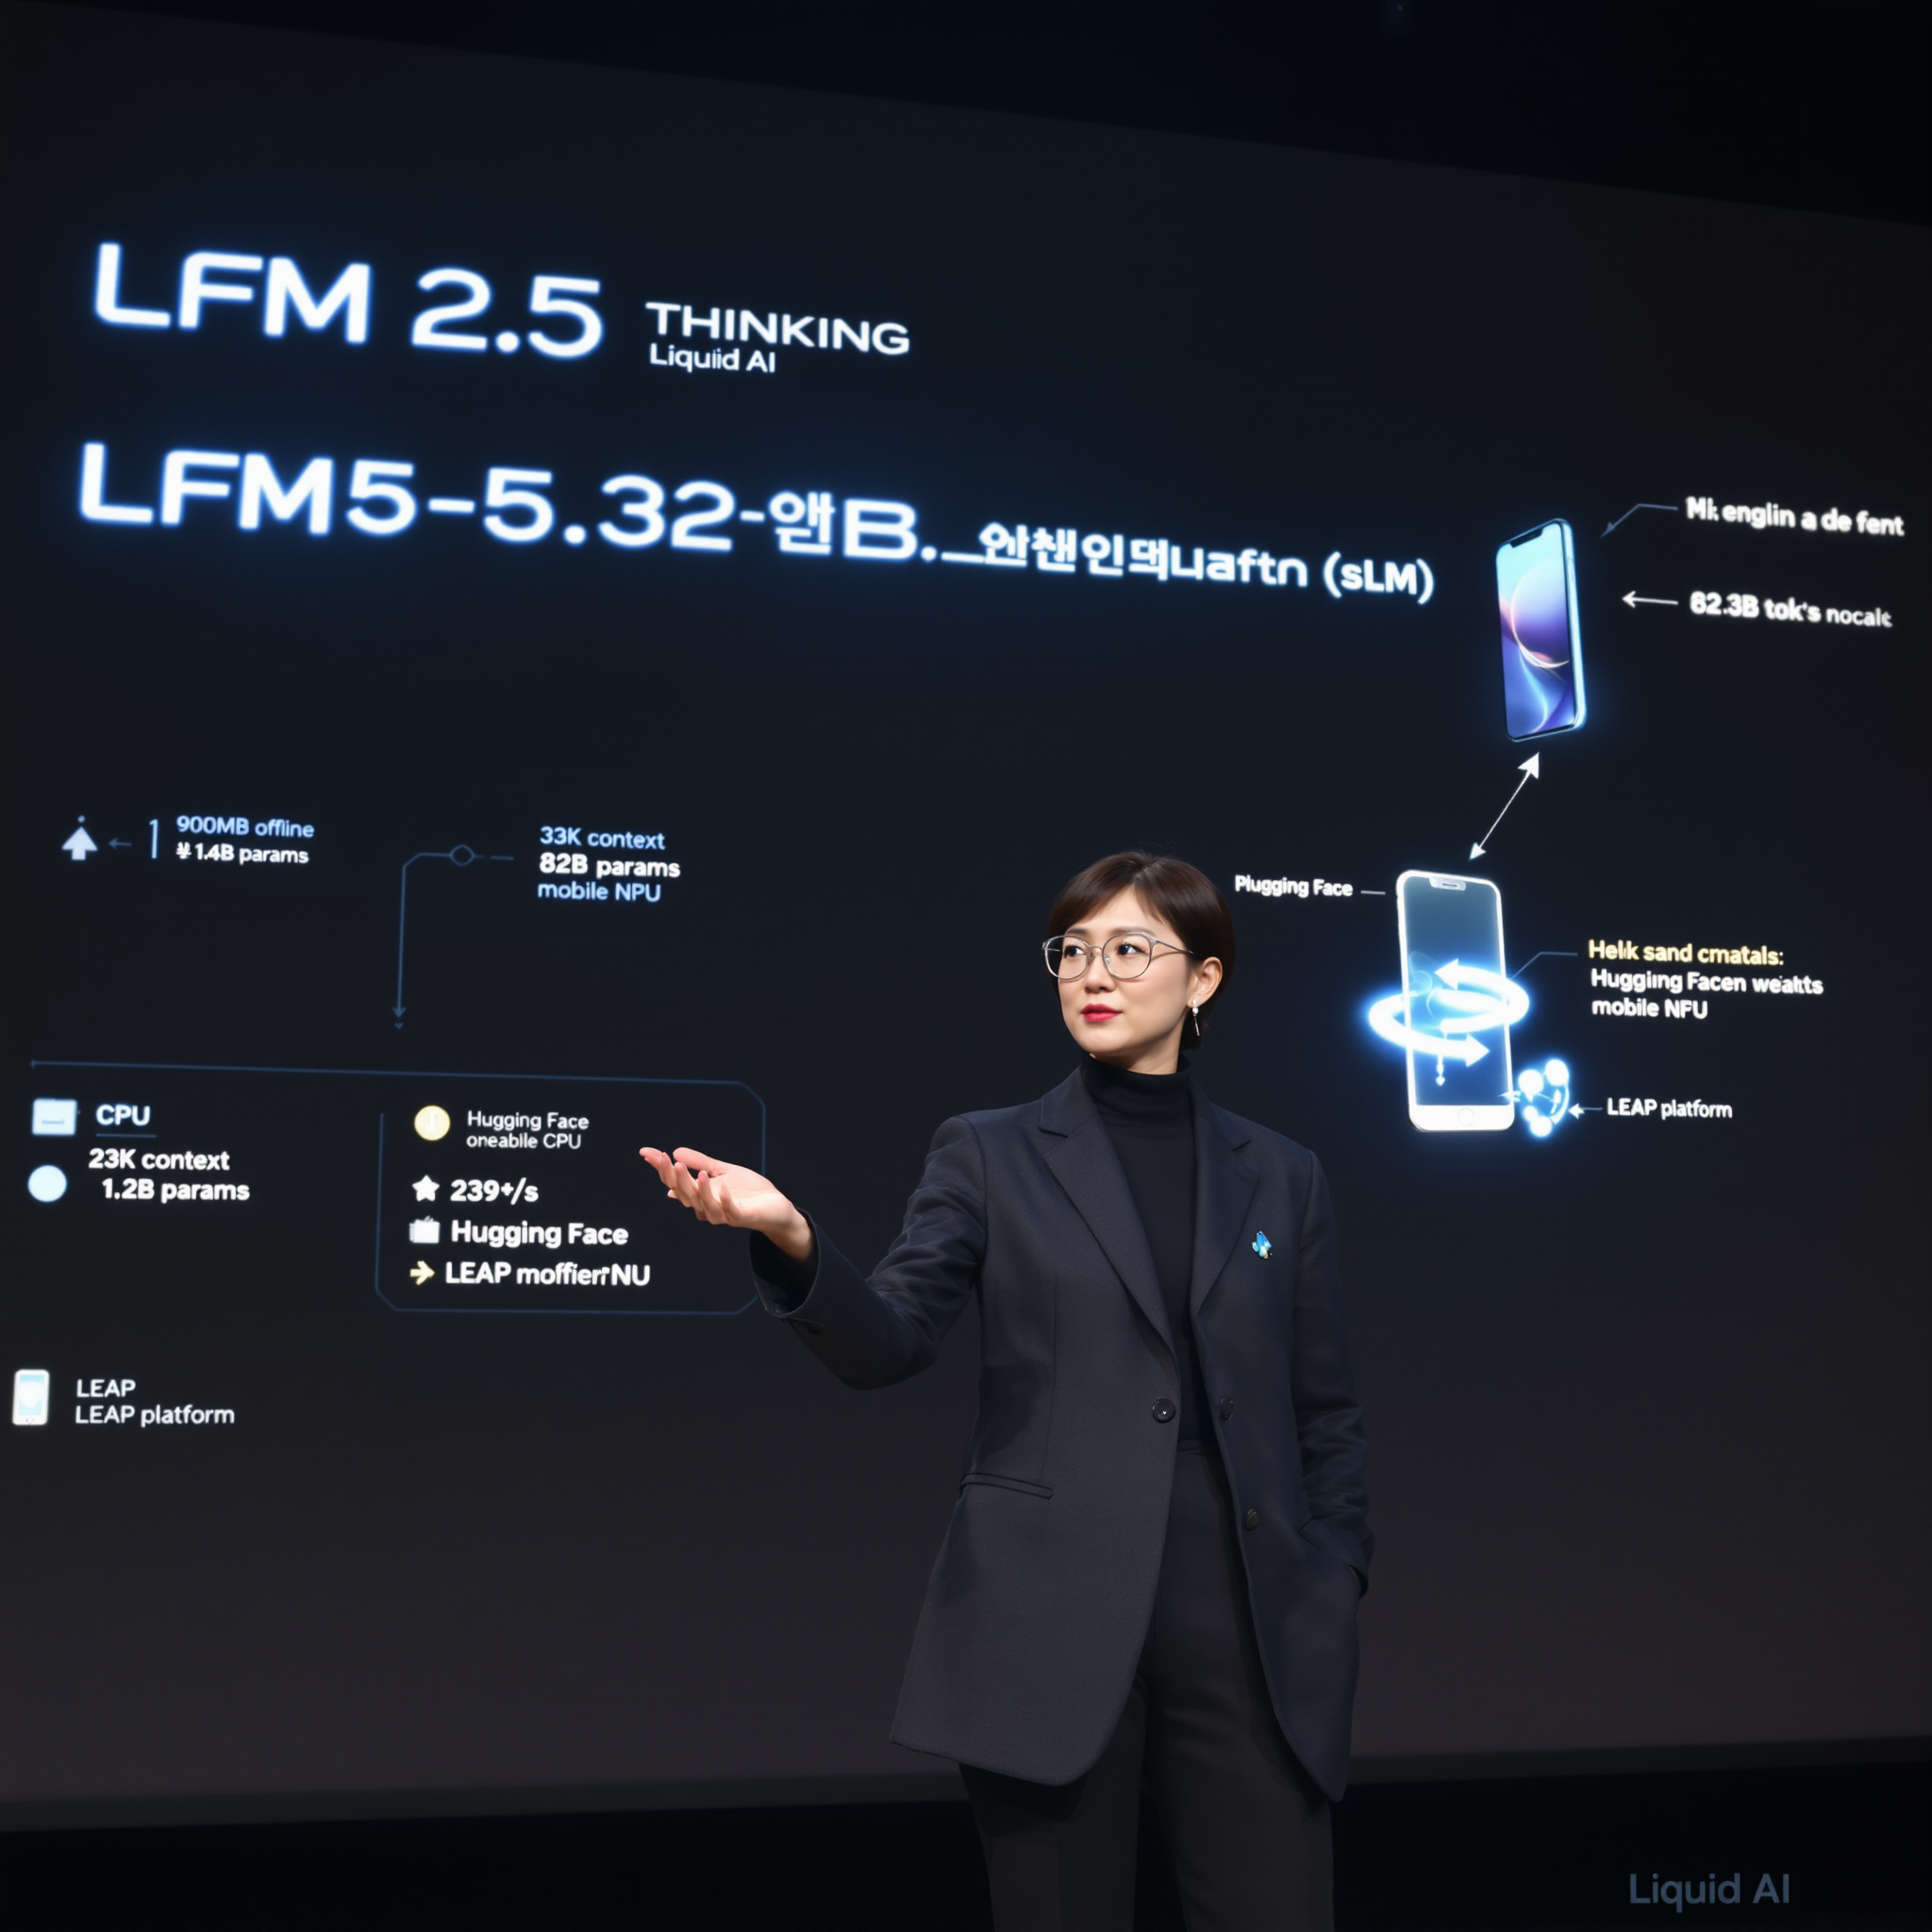
- 최신 스마트폰에서도 완전 오프라인으로 ‘사고 과정’을 실행하는 소형 추론 모델이 나왔습니다. 리퀴드 AI(액체 신경망)가 공개한 LFM2.5-1.2B-싱킹은 소형 언어모델(sLM)로서 온디바이스 AI와 오프라인 추론 환경을 목표로 설계되었습니다. 이 모델은 약 11.7억 매개변수, 32K 컨텍스트 길이, 8개 언어 지원(영어·한국어·중국어·일본어·프랑스어·독일어·스페인어·아랍어)을 제공하면서도 1GB 미만(약 900MB) 메모리로 동작합니다. 허깅페이스 오픈 웨이트와 리퀴드 AI의 LEAP 플랫폼을 통해 배포되어 바로 실험해볼 수 있습니다.
모델 개요 — LFM2.5 계열과 싱킹(Thinking) 소개

LFM2에서 확장된 LFM2.5 계열은 엣지 및 온디바이스 환경을 우선 목표로 삼아 설계된 텍스트 전용 범용 모델입니다. 그중 LFM2.5-1.2B-싱킹(Thinking)은 ‘사고 중심’ 추론을 특징으로 하며, 내부적으로 플래닝 단계(사고 추적, thinking traces)를 생성한 뒤 최종 응답을 출력합니다. 주요 사양은 다음과 같습니다.
- 파라미터: 약 11.7억(표기상 1.2B)
- 컨텍스트 길이: 32K 토큰
- 지원 언어: 영어·한국어·중국어·일본어·프랑스어·독일어·스페인어·아랍어(총 8개)
- 메모리 요구량: 약 900MB(1GB 미만)
- 배포: 허깅페이스 오픈 웨이트 및 LEAP 플랫폼 제공
핵심 기술 및 차별점
사고 추적(thinking traces)
LFM2.5-1.2B-싱킹의 핵심은 추론 전에 내부적으로 생성되는 사고 추적입니다. 입력을 받은 뒤 문제 해결 계획, 잠재적 도구 호출 준비, 단계별 검증 등을 먼저 구성하고 이를 바탕으로 최종 답변을 만듭니다. 이러한 플래닝 중심 구조는 에이전트형 작업에서 ‘플래닝 브레인(planning brain)’ 역할을 수행하도록 설계되어 있습니다.
다단계 강화학습과 합성 체인 기반 미세조정
모델은 추가적인 사전 학습과 다단계 강화 학습(RL), 합성 체인 기반 미세조정, 선호 정렬(Preference Tuning) 등을 거쳐 성능과 안정성을 높였습니다. 특히 중간 학습 단계에서 추론 트레이스를 포함해 학습함으로써 사고 과정의 유용성을 실제 추론에서 반영하도록 만들었습니다.
둠 루프(doom looping) 감소 전략
소형 모델이 흔히 겪는 문제인 둠 루프(사고 과정을 반복하며 답변을 끝내지 못함) 발생률을 크게 낮춘 점이 주목됩니다. 학습 과정에서 추론 트레이스를 포함시키고 RL 기반 튜닝을 적용한 결과, 둠 루프 발생률이 약 15.74%에서 0.36%로 감소했습니다.
하드웨어 효율성
온디바이스 구동을 위해 하드웨어 효율성도 핵심 설계 목표였습니다. 벤치마크상 LFM2.5-1.2B-싱킹은 AMD CPU에서 초당 약 239 토큰, 모바일 NPU에서는 약 82 토큰을 처리할 수 있으며, 1GB 미만 메모리로 구동 가능합니다. 따라서 최신 스마트폰의 모바일 NPU를 활용한 로컬 추론이 현실적입니다.
성능·벤치마크 요약
- 수학 추론(MATH 500): LFM2.5-1.2B-Instruct 대비 63 → 88점으로 대폭 향상
- 지시 이행(Multi-IF): 61 → 69점 향상
- 도구 사용 능력(BFCLv3): 49 → 57점 개선
- 일부 벤치마크에서는 파라미터가 더 큰 모델(예: 큐원3-1.7B 싱킹 모드)과도 경쟁력 있는 성능을 보였으며, 파라미터 수는 약 40% 적고 출력 토큰 수도 적은 이점이 확인되었습니다.
추천 활용처 및 적용 시나리오

LFM2.5-1.2B-싱킹은 온디바이스 플래닝이 필요한 시나리오에서 특히 유용합니다.
- 권장 적용: 에이전트형 작업(플래닝 브레인), 데이터 추출 파이프라인, RAG(검색 증강 생성) 시스템의 로컬 플래너
- 온디바이스 사례: 스마트폰 오프라인 어시스턴트(네트워크 없이 플래닝 가능), 차량·IoT·임베디드 기기의 로컬 추론, 프라이버시 민감 애플리케이션(로컬 데이터 유지)
- 비권장 작업: 대규모 지식 리포지토리에 기반한 지식 집약적 작업, 복잡한 프로그래밍 생성·검증(정밀한 코드 생성 등) — 이 경우 클라우드 기반 고성능 모델 보완 권장
도입 시 고려사항(제약·리스크)
- 모델 규모의 한계: 소형 파라미터 수로 인해 매우 전문적이거나 복잡한 추론에는 한계가 있음.
- 언어·도메인 범위: 공식 지원 언어는 8개로 기타 언어·전문화된 도메인에서는 성능 저하 가능.
- 기기별 변동성: 실제 처리량과 응답 시간은 NPU/CPU 세부 사양, 메모리 상황, 전력 제한에 따라 달라짐.
- 안전성 이슈: 중간 플래닝 단계가 때로 불필요한 루프나 부정확한 도구 호출을 유발할 수 있으므로 검증·모니터링 체계 필요.
구현 가이드 — 간단 체크리스트
- 배포 옵션 선택:
- 허깅페이스 오픈 웨이트로 빠른 실험 및 커스터마이즈
- LEAP 플랫폼으로 관리형 배포·모니터링 선택
- 하드웨어 요구사항: 메모리 900MB~1GB 확보, 모바일 NPU 최적화(Quantization·NPU-friendly 연산 사용) 권장
- 통합 팁: RAG나 에이전트 파이프라인에서 ‘플래닝 단계’만 LFM2.5-1.2B-싱킹에 맡기고 실제 데이터 집계·정답 생성은 경량화된 후단으로 처리 → 응답 시간 및 자원 최적화
- 모니터링 지표: 둠 루프 발생률, 도구 호출 실패율, 응답 일관성(정확도) 지표 수집 및 주기적 미세조정
비즈니스 관점의 가치 제안
- 프라이버시 강화: 오프라인 추론으로 사용자 데이터 로컬 보관 가능
- 지연 시간 감소: 네트워크 왕복 없이 즉시 플래닝·응답 제공
- 비용 절감: 클라우드 추론 비용 및 대역폭 절감
- 제품 차별화: 온디바이스에서 동작하는 고급 플래닝 기능으로 경쟁 우위 확보
결론
LFM2.5-1.2B-싱킹은 액체 신경망 접근을 기반으로 한 소형 언어모델(sLM)로서 온디바이스 AI와 오프라인 추론의 실용성을 한 단계 끌어올렸습니다. 사고 추적(thinking traces)과 강화학습 기반 튜닝으로 성능과 안정성을 개선했고, 둠 루프(doom looping) 발생률을 현저히 낮췄습니다. 에이전트형 작업, RAG, 데이터 추출 파이프라인 등 로컬 플래닝이 필요한 시나리오에 적합하며, 지식 집약적·프로그래밍 중심 작업에는 클라우드 보완이 권장됩니다.
지금 해볼 것: 허깅페이스 오픈 웨이트 또는 리퀴드 AI의 LEAP 플랫폼에서 LFM2.5-1.2B-싱킹을 내려받아 실제 디바이스(모바일 NPU/노트북)에서 성능·안정성을 테스트해 보시기 바랍니다.
추천 시각 자료(제작 제안)
- 모델 개요 카드: 파라미터·컨텍스트·언어·메모리·처리량(239 tok/s · 82 tok/s)
- 사고 추적 흐름도: 입력 → 플래닝 트레이스 → 도구 호출 준비 → 최종 응답
- 벤치마크 비교 차트(MATH500, Multi-IF, BFCLv3)
- 둠 루프 발생률 전후 그래프(15.74% → 0.36%)
- 온디바이스 RAG + 플래닝 브레인 아키텍처 다이어그램
키워드(본문 포함): 리퀴드 AI, LFM2.5-1.2B-싱킹, 온디바이스 AI, 소형 언어모델(sLM), 오프라인 추론, 액체 신경망, 사고 추적(thinking traces), doom looping, 모바일 NPU, 허깅페이스 오픈 웨이트, LEAP 플랫폼.


댓글 남기기